01要点
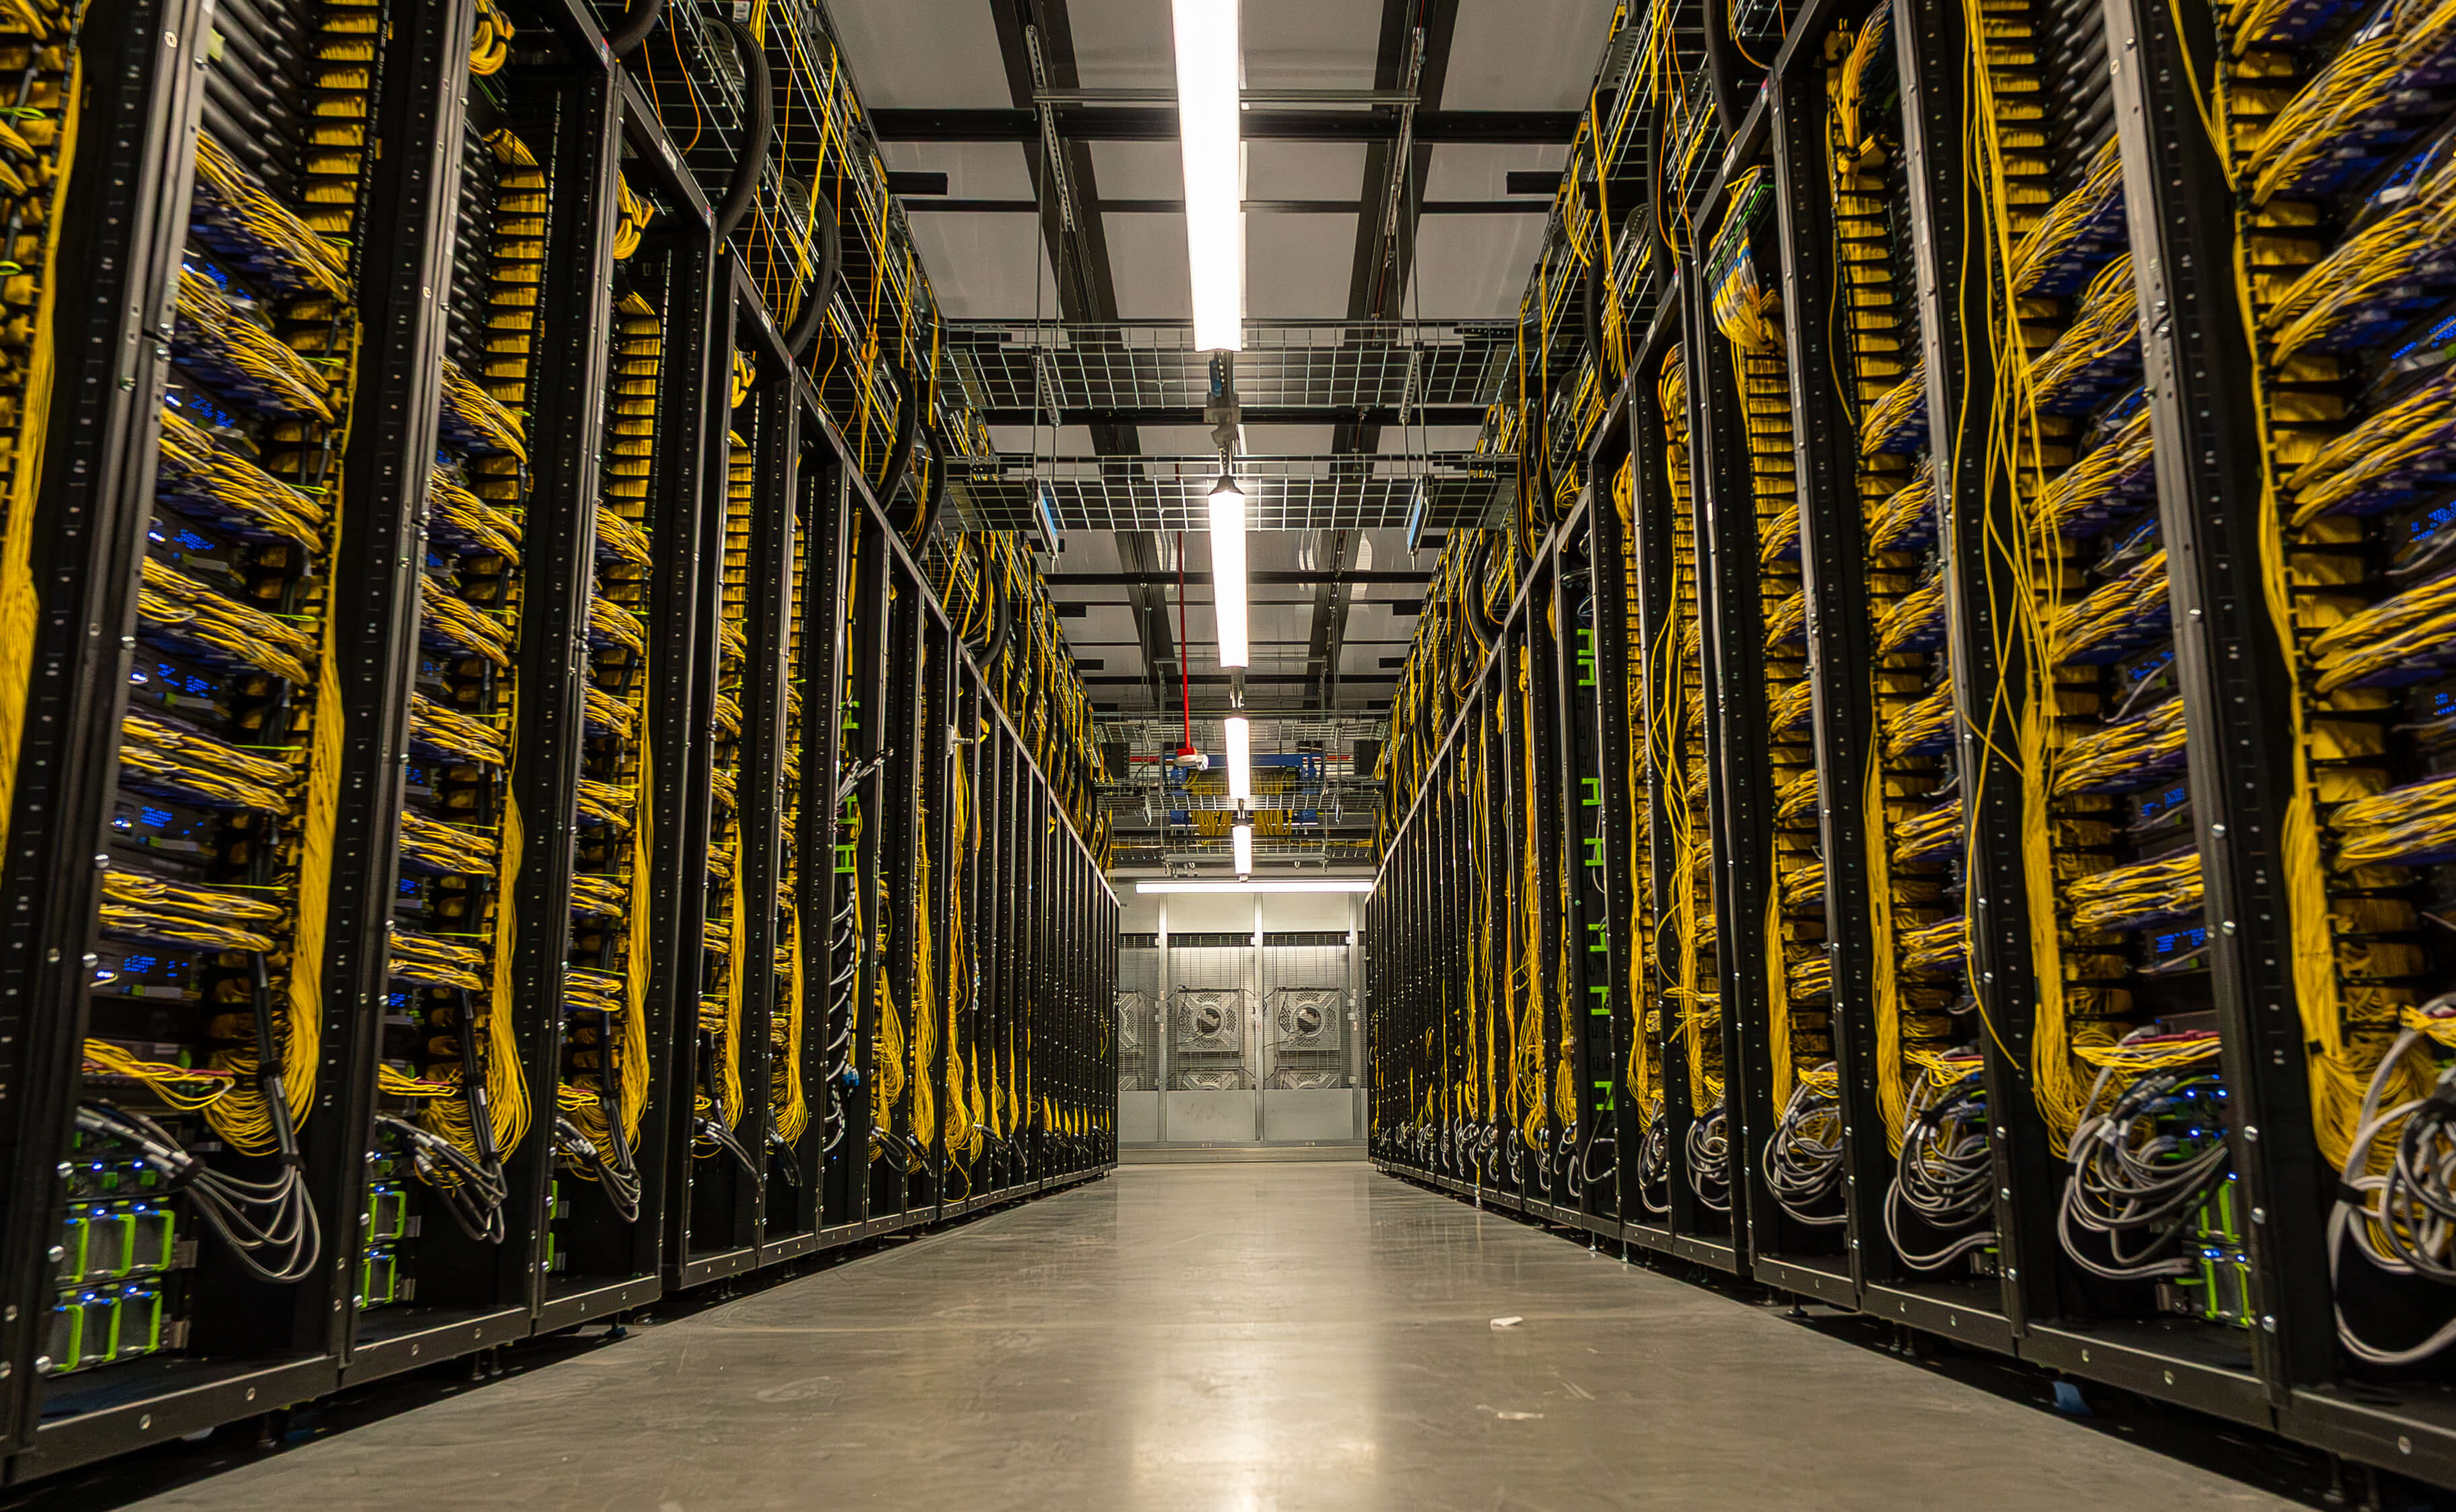
Meta 在工程博客公开俄亥俄州 New Albany 的吉瓦级 AI 训练集群 Prometheus:一期已经完工,并用来训练 Muse 系列基础模型(含 Muse Wonder)。集群现在跨多栋楼跑着数十万块 GPU,目标是满配大约 100 万块、当作一台机器协同训练。现网主要是英伟达 GB200、GB300 的 NVL72 机架,Vera Rubin NVL72 也在接入计划里。公司还给出少见的运维数字:预训练有效算力占比超过 85%,强化学习超过 90%,训练 Muse Wonder 时平均约 4.7 万 GPU 小时才遇一次中断,并称一年内中断率降了约 99%。
02发生了什么
两年前 New Albany 还是偏传统网页流量机房。Meta 说靠硬件、网络和建筑改造,把这里改成前沿模型训练场,分阶段扩容。一期已完成;后续还会继续扩,并把经验用到路易斯安那 Hyperion 等下一代超算规划上。
硬件上,Prometheus 目前两套平台:Catalina 用 GB200 NVL72(Ariel 双机架、每域 72 卡),Clemente 用 GB300 NVL72(单机架 72 卡、HBM 提到每卡 288GB)。下一代 San Miguel 将上 Vera Rubin NVL72。训练流量走独立以太网后端,单栋楼织物最多可连约 2 万块 GPU,楼宇之间聚合网络跨度可到 100 公里以上。
可靠性是文章重点:NVL72 故障半径大,所以每架常留 8 卡热备、另备约 2% 机架;和英伟达团队驻场共查中断根因;固件可在数小时内推到十万级 GPU。同步训练会带来数十兆瓦级功率抖动,集群用电有逐步限功率和电池缓冲。
官方账号 @AIatMeta 同日发帖指向这篇博文,Techmeme 与多家科技媒体跟进。社区向的 Data Centers 站点也写了 New Albany 与 Muse 训练的关系,数字细节以工程博文为准。
03共识/分歧
- 共识:这是大厂少有地把吉瓦级训练侧规模、机架代际和 goodput/中断指标写到公开渠道;时间点卡在 Meta 本周财报前,市场会拿它对照资本开支与模型节奏。
- 分歧/待观察:满配「约 100 万 GPU」是规划口径,不是当下库存盘点;具体功耗、总投资、与外部云算力长约的关系文中未量化。有人把重点放在与英伟达「共址联调」关系,有人更关心后续 Hyperion 和财报指引。
04舆论与逻辑
科技圈讨论集中在三点:一是「一台机器」跨楼训练是否成为超大规模标配;二是 85%+ goodput 和中断率骤降,说明软件与固件工程和堆卡同样决定有效算力;三是财报周前释放基建细节,容易被解读成「开支看得见、效率也在讲故事」。卖方与社交平台上亦有人提醒:公开的是 Meta 自选指标,横向对比其他云厂仍缺统一口径。
05依据与来源
- Meta Engineering:Inside Prometheus: Meta's Journey to a Gigawatt-Scale Supercluster(2026-10-19)
- Meta Data Centers:New Albany 社区稿(同日,定性印证)
- @AIatMeta 官方帖(推文 id 2112245968750145561)
- Techmeme / StorageReview 等转述与配图
06影响标注
利好
META公开吉瓦级自建训练产能与运维效率,强化「自研模型有算力底座」叙事。NVDA文中明确现网与规划机架均为英伟达 NVL72 路线(GB200/GB300,Vera Rubin 将至),并强调驻场共研。
利空
- 无
中性
- 云与 AI 基础设施 披露抬高行业对大规模训练可靠性的讨论,但未给可交易的资本开支新数字。